§ Fallo de piloto · Deuda técnica · Integración · Escalado

De piloto a producción: por qué los proyectos de IA industrial se estancan y cómo resolverlo.

La mayoría de pilotos de IA industrial que demuestran valor en un entorno controlado nunca alcanzan producción sostenida. Las razones rara vez son de precisión del modelo — son de infraestructura de datos que no se puede automatizar, integración con MES, SCADA y PLC que nunca se probó, deuda técnica acumulada durante el sprint hacia la demo, y organizaciones que no han asignado responsabilidad del modelo en producción. Esta guía desglosa los cuatro patrones de fallo y proporciona un marco de escalado para pasar de piloto a producción con confianza.

Díganos qué necesita. En 48 h le proponemos a los expertos que encajan.

Dos o tres perfiles de nuestra red, con disponibilidad y condiciones orientativas. Sin coste ni compromiso.

Busco

Gracias. Contrastamos su brief con la red y le proponemos dos o tres expertos en 48 horas laborables. Todas las conversaciones son confidenciales.

Perfiles compartidos de forma confidencial. Si nadie de la red encaja, se lo diremos con la misma rapidez. ¿Brief más detallado? Complete el brief largo →

Esta guía está escrita desde la perspectiva de profesionales que han dirigido proyectos de IA industrial desde el piloto hasta la producción escalada en plantas de automoción, alimentación, farmacéutica y energía. Aborda los cuatro patrones que bloquean repetidamente la transición, y proporciona un marco de escalado de cinco etapas que los equipos de producción pueden aplicar directamente.

ParaLíderes de operaciones y tecnología que escalan pilotos de IA
AlcanceDatos · Integración · Deuda técnica · Organización
OutputMarco de escalado de cinco etapas con hitos go / no-go
01 Por qué los pilotos se estancan

Cuatro patrones que bloquean el camino a producción.

Los pilotos de IA industrial suelen empezar con un caso de uso prometedor, un equipo de data science capaz y una ventana de patrocinio ejecutivo. El piloto demuestra que el modelo puede detectar defectos, predecir paradas u optimizar un parámetro. Entonces el proyecto se estanca. Entender por qué requiere mirar más allá del modelo y hacia la infraestructura, la ruta de integración, la calidad del código y la organización que lo rodea.

Los cuatro patrones que siguen no son independientes — se refuerzan entre sí. Un piloto con infraestructura de datos frágil también tiende a acumular deuda técnica, porque el equipo parchea el pipeline manualmente en lugar de reconstruirlo. Un piloto sin pruebas de integración tiende a carecer de responsabilidad organizativa, porque nadie en planta ha interactuado con el sistema. El marco de escalado de la sección 02 aborda los cuatro conjuntamente.

Para una visión más amplia de la planificación de iniciativas de IA, consulte nuestra hoja de ruta de IA industrial. Para la perspectiva financiera de cuándo un proyecto merece ser escalado, consulte nuestra guía de ROI de proyecto.
02 El marco de escalado

Cinco etapas de piloto a producción sostenida.

EtapaObjetivoHito go / no-go
1. Validación de pilotoProbar que el modelo funciona con datos en vivo de planta, no solo históricos. Cubrir al menos un ciclo completo de producción incluyendo cambios de turno y ventanas de mantenimiento.Go: la precisión se mantiene en datos en vivo durante 4–12 semanas. No-go: la precisión se degrada bajo condiciones reales.
2. Automatización del pipeline de datosSustituir la extracción, limpieza y etiquetado manual por un pipeline automatizado y monitorizado. El modelo debe ser reentrenable sin intervención de un ingeniero de datos.Go: el pipeline opera sin supervisión y alerta ante fallos. No-go: el pipeline requiere pasos manuales para funcionar.
3. Integración con sistemas de plantaConectar la IA a MES, SCADA, PLC y ERP mediante interfaces documentadas. Probar el failover: ¿qué pasa cuando el modelo o la red no están disponibles?Go: integración probada con datos en vivo de planta y failover verificado. No-go: integración diseñada pero no probada.
4. Traspaso organizativoAsignar un responsable del modelo en el equipo de operaciones. Formar a operadores y personal de mantenimiento. Definir la ruta de escalado cuando las predicciones son erróneas o el modelo deriva.Go: responsable identificado, formado y accountable. No-go: el modelo sigue siendo un proyecto de data science sin responsable de operaciones.
5. Despliegue escaladoDesplegar en líneas, turnos o plantas adicionales. Monitorizar la deriva del modelo, reentrenar con calendario y medir el impacto en throughput, calidad y downtime de forma continua.Go: el despliegue funciona con monitorización y reentrenamiento activos. No-go: no existe plan de monitorización ni reentrenamiento.
03 Riesgos y errores comunes

Dónde falla la transición en la práctica.

01

Ejecutar el piloto sobre datos preparados manualmente

Un piloto que funciona con exports CSV limpiados a mano no prueba nada sobre viabilidad de producción. La primera pregunta tras un piloto exitoso debería ser: ¿se puede automatizar este pipeline de datos? Si no, el piloto no es escalable.

02

Posponer la integración con MES y SCADA

La integración se trata a menudo como una tarea post-piloto. En realidad, las restricciones de integración — segmentación de red, interlocks de seguridad, requisitos de latencia — condicionan lo que el modelo puede hacer. Diseñe la ruta de integración antes del piloto, no después.

03

Acumular deuda técnica durante el sprint

La presión de mostrar una demo funcional lleva a atajos: rutas hardcodeadas, modelos sin versionar, preprocesamiento indocumentado. Esta deuda hace el piloto imposible de mantener y peligroso de escalar. Refactorice antes de escalar, no después.

04

Dejar la responsabilidad del modelo sin definir

Sin un responsable designado en el equipo de operaciones, nadie monitoriza la deriva, dispara el reentrenamiento o escala cuando las predicciones se degradan. El modelo pierde precisión silenciosamente hasta que alguien detecta un problema de calidad aguas abajo.

05

Escalar antes de probar el failover

Si el modelo cae y la línea se para, el piloto se convierte en un pasivo. El failover — degradación graceful al proceso anterior — debe probarse antes de escalar a líneas o plantas adicionales.

06

Medir precisión en lugar de impacto de negocio

Un modelo con 95% de precisión que los operadores no confían entrega cero valor. Mida throughput, tasa de defectos, downtime y adopción de operadores — no solo métricas del modelo — para decidir si escalar.

04 Preguntas frecuentes

Sobre el escalado de pilotos de IA industrial.

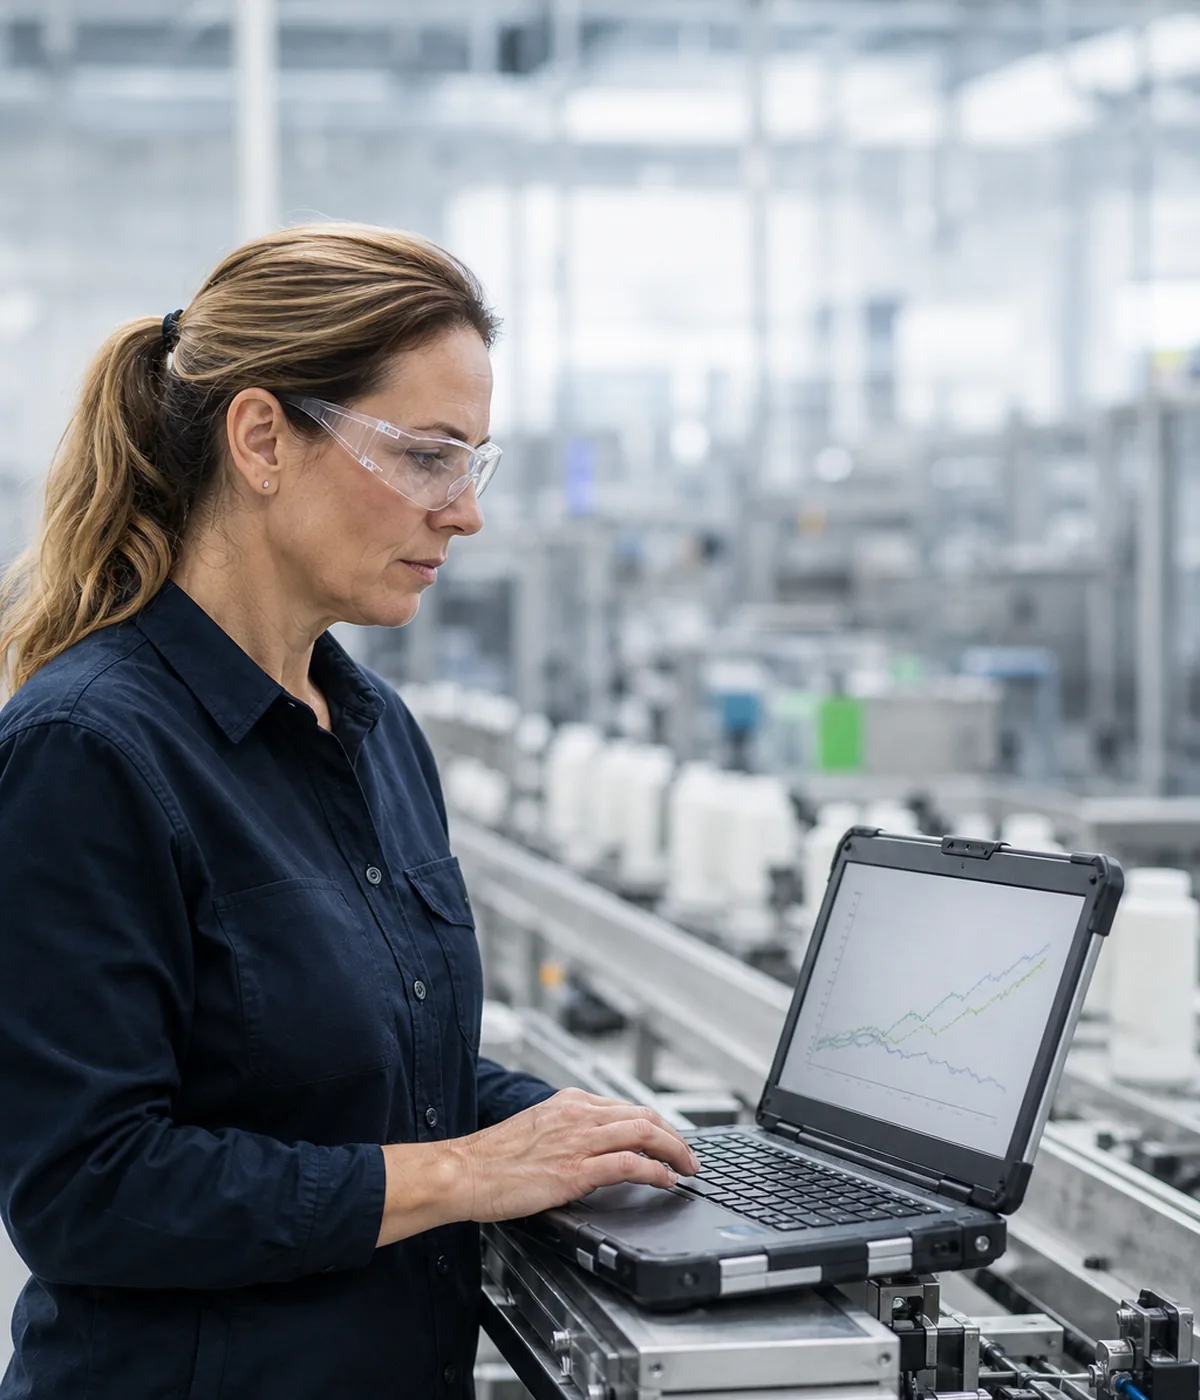
Ingeniera revisando datos de producción junto a una línea de fabricación automatizada.
¿Qué porcentaje de pilotos de IA industrial llega a producción?

La cifra exacta varía según el estudio y el sector, pero los profesionales coinciden en que la mayoría de los pilotos de IA industrial nunca alcanzan producción sostenida. La brecha rara vez es la precisión del modelo — es la infraestructura de datos, la integración y la preparación organizativa lo que bloquea la transición.

¿Cuál es la razón más común por la que los pilotos fallan?

La infraestructura de datos. Los pilotos a menudo funcionan con datos extraídos, limpiados y etiquetados manualmente que no pueden reproducirse en producción. Cuando el piloto termina y el ingeniero de datos se va, no hay pipeline automatizado para alimentar el modelo.

¿Cuánto debe durar un piloto antes de escalar?

Un piloto debe ejecutarse el tiempo suficiente para cubrir al menos un ciclo completo de producción — incluyendo cambios de turno, ventanas de mantenimiento y variación estacional. Para la mayoría de entornos de fabricación esto significa de cuatro a doce semanas de operación en vivo antes de una decisión de escalado.

¿Debemos integrar con MES y SCADA antes o después del piloto?

La integración debe diseñarse antes del piloto y probarse durante el mismo. Un piloto que lee de un export CSV manual pero afirma integrarse con MES no es un piloto — es un notebook. La ruta de integración debe probarse antes de comprometer el escalado.

¿Quién debe ser responsable del modelo tras el lanzamiento a producción?

Una persona designada del equipo de planta u operaciones, no solo del equipo de data science. La responsabilidad del modelo incluye monitorizar la deriva, disparar el reentrenamiento y escalar cuando las predicciones se degradan. Sin un responsable claro, el modelo decae silenciosamente.

Recursos relacionados: nuestro servicio de dirección de proyectos proporciona asesores senior que asumen responsabilidad directa por llevar la IA de piloto a producción, y nuestra guía de arquitectura cubre la integración técnica con MES, SCADA, edge y IA generativa. Para retos de escalado sectoriales, consulte nuestras páginas de alimentación y bebidas y automoción.

05 Solicitar expertos

¿Atascado entre piloto y producción?

Díganos el caso de uso, el sector y dónde se bloquea el proyecto. Le proponemos profesionales que han llevado IA industrial hasta producción sostenida.

Prefiero enviar un brief detallado

Díganos qué necesita. En 48 h le proponemos a los expertos que encajan.

Dos o tres perfiles de nuestra red, con disponibilidad y condiciones orientativas. Sin coste ni compromiso.

Busco

Gracias. Contrastamos su brief con la red y le proponemos dos o tres expertos en 48 horas laborables. Todas las conversaciones son confidenciales.

Perfiles compartidos de forma confidencial. Si nadie de la red encaja, se lo diremos con la misma rapidez. ¿Brief más detallado? Complete el brief largo →